2026. 10. 3. 15:39ㆍAI
사내 코드리뷰 에이전트가 처음으로 "LGTM, 지적사항 없음"을 남겼습니다. 그동안 한 번도 없던 일이라 솔직히 좀 얼떨떨했죠.
회사 전자의무기록(EHR) 프로젝트에는 PR이 올라오면 Claude Code 크론 세션이 리뷰를 다는 에이전트가 있어요. 그동안은 P1, P2 권장 변경사항이 꼭 몇 개씩 붙었고, 지금도 붙습니다. 달라진 건 Claude Code와 Codex를 동료로 붙인 오케스트레이션으로 작업한 PR부터 "지적사항 없음"이라는 결과가 처음으로 나오기 시작했다는 것이죠.
이 글은 그 오케스트레이션을 담은 플러그인 peer-coding을 왜 만들었고 어떻게 설계했는지에 대한 기록이에요. 앞선 글에서 플러그인을 마켓플레이스 하나로 모으며 plan-smith를 은퇴시켰다고 썼는데 그 빈자리에 들어온 첫 번째 플러그인입니다.
🔗[ Claude Code Plugin ] 필요해서 만든 플러그인을 통합했습니다, 한 개는 빼고요
내가 둘이어도 못하는 건 그대로입니다
여러 CLI 세션을 띄워 관리하는 런타임인 Orca 위에서 오케스트레이션을 처음 돌렸을 때 제가 한 일은 단순했어요. 메인 에이전트 하나가 계획을 세우고 같은 Claude 모델 여러 개를 워커로 띄워 나눠 맡기고, 끝나면 다시 Claude가 리뷰하는 구조였죠. 빨라지긴 했고요. 리뷰도 분명 잡아내는 게 있었어요. 그런데 한계가 또렷했습니다. 같은 추론 모델이라 잘하는 것은 잘해놓고, 스스로 다시 돌아보면 또 다른 것만 보였거든요. 둘 다 못 보는 자리는 그대로 남았고, 그 구조에서는 "지적사항 없음"을 단 한 번도 보지 못했어요.
"같은 모델을 둘 띄우면, 리뷰는 왜 여기서 멈출까?"
라고 한동안 생각했는데, 답은 모델의 바탕에 있었어요. 에이전트는 확률로 출력을 내고 그 확률은 모델이 학습한 바탕에서 나옵니다. 그러니 같은 모델 두 개는 잘하는 것도 같고 못하는 것도 같겠다는 생각이 들었어요. 제가 둘이라면 제 역량만큼의 생산성은 두 배가 되겠지만 제가 근본적으로 못하는 일은 둘이 되어도 해결되지 않는 것과 같습니다. 개선은 되지만, 그 개선이 닿는 범위가 같은 거죠.
그래서 질문을 바꿨어요. 더 많은 Claude가 아니라 저와 역량이 다른 동료가 필요한 게 아닐까 하고요. 마침 개인 계정으로 Codex를 쓰기 시작한 참이었고 회사에서 제공해주는 Claude Code 프리미엄 시트와 함께 돌릴 수 있었죠.
서로 다르게 틀리는 두 모델
peer-coding의 전제는 한 문장입니다. 바탕이 다른 두 모델은 서로 다른 방식으로 틀린다. 같은 모델의 자기 리뷰는 자기가 잘 보는 자리를 다시 볼 뿐이지만, 엔지니어링 방식 자체가 다른 벤더의 리뷰는 서로 교차하는 자리를 볼 가능성이 높아져 상호 보완이 된다는 거예요. 이건 측정으로 확인한 사실이 아니라 설계의 전제입니다.
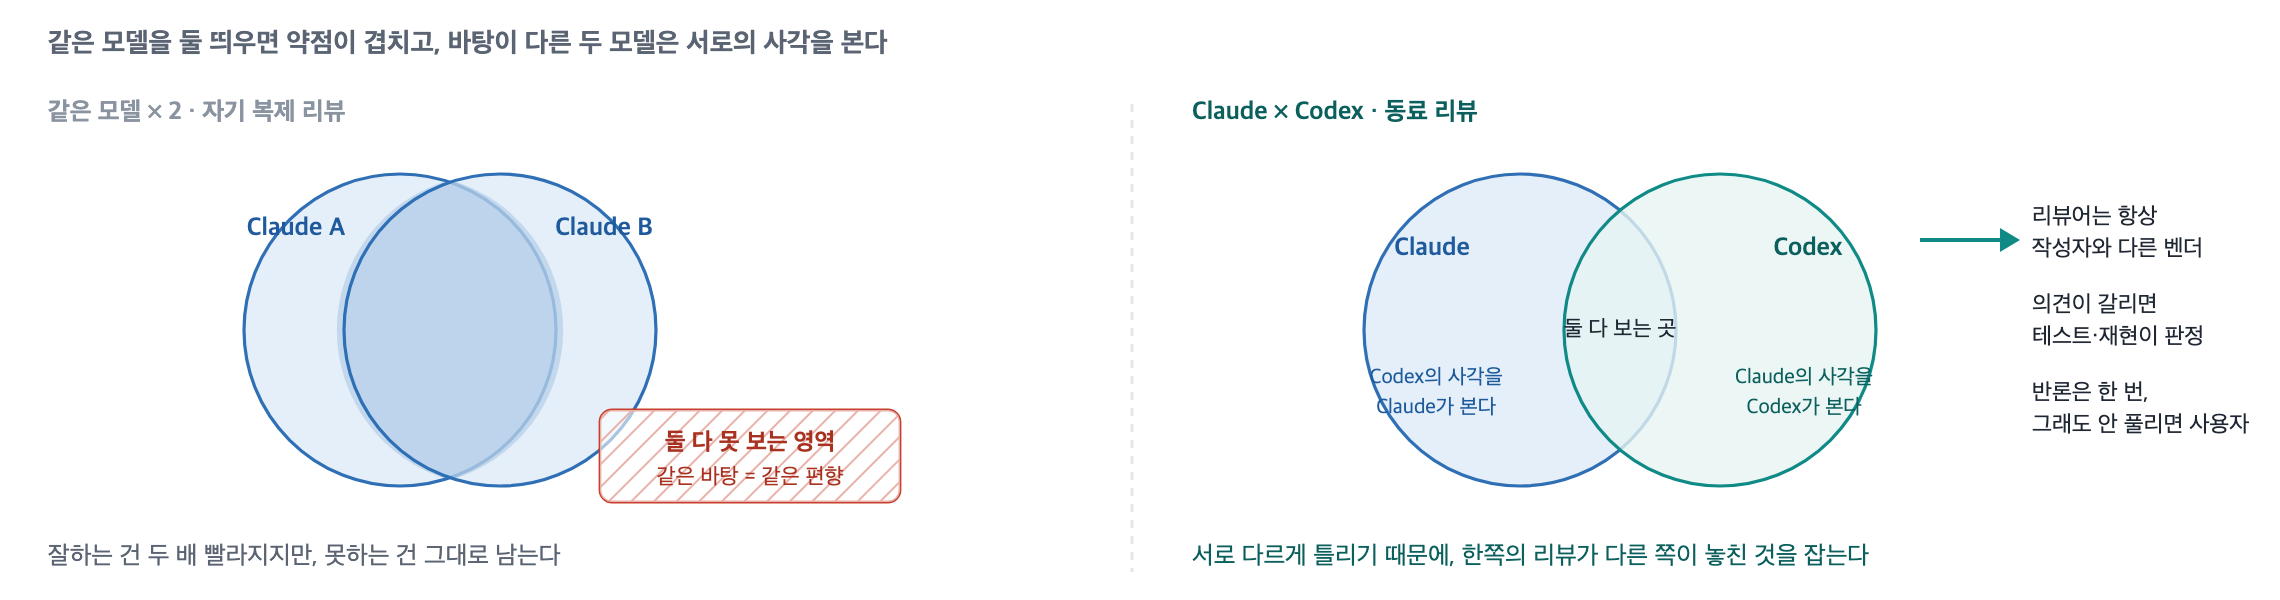
이 전제에서 규칙 몇 개가 따라 나와요.
- 리뷰어는 항상 작성자와 다른 벤더예요. Claude가 쓴 코드는 Codex가, Codex가 쓴 코드는 Claude가 봐요.
- 메인 에이전트의 계획도 예외가 아니에요. 사용자에게 보여주기 전에 상대 벤더의 리뷰를 먼저 받습니다. 틀린 계획으로 병렬 작업을 돌리는 것이 가장 비싼 실패니까요.
- 의견이 갈리면 역할이 아니라 증거가 판정합니다. 테스트, 재현, 트레이스를 가진 쪽의 말이 남고 둘 다 없으면 사용자가 정해요.
- 메인이 기각한 지적 가운데 심각도가 높은 blocking·major 등급은 이유와 함께 리뷰어에게 한 번 돌아가요. 리뷰어가 수긍하거나 새 증거로 반박하고 그래도 안 풀리면 DISPUTED로 양쪽 주장을 나란히 사용자에게 올려요. 반론은 딱 한 번인데 둘이 끝없이 논쟁하는 걸 막으려고요.
- 리뷰어는 보고만 하고 고치지 않습니다. 읽기 전용으로 돌고 두 CLI가 스키마로 강제하는 JSON을 돌려줘요.
렌즈도 나눴습니다. Codex가 Claude의 작업을 볼 때는 적대적 입력, 엣지 케이스, 에러 경로, 테스트가 변경을 실제로 건드리는지, 그리고 유창한 코드 뒤에 숨은 검증 안 된 가정을 보게 했어요. Claude가 Codex의 작업을 볼 때는 계획 문서 plan.md의 문제를 푸는지 아니면 글자 그대로의 태스크만 푸는지, 기존 패턴과의 일관성, 테스트는 통과하지만 요점을 놓친 구현을 보게 했고요. 제가 써 보며 두 모델이 다르게 보였던 지점에서 출발한 것이라 결과가 다르게 나오면 바꿀 생각이에요.
속도는 레인에, 품질은 관문에
워커와 리뷰어의 모델을 다르게 둔 것도 설계 포인트예요. 작업을 어떤 모델로 보낼지 정해 둔 경로를 레인이라고 부르는데, 작업은 가벼운 모델이 빠르게 하고 리뷰는 무거운 모델이 깊게 봅니다.
| 레인 | 모델 · effort | 보내는 작업 |
| claude-fast | Claude 최신 Sonnet · high | UI, 인터랙션, 스타일링, Claude 쪽 도구나 MCP가 필요한 일 |
| codex-bulk | Codex 최신 Luna · high | 기존 계약에 대한 테스트, 타입, 기계적 마이그레이션처럼 정답이 정해진 일 |
| main | 메인 에이전트 | 결합이 강한 변경, 아직 명세를 찾아가는 작업 |
| 리뷰어 | Claude 최신 Opus / Codex 최신 sol · xhigh | 계획 리뷰, 페이즈 리뷰, 델타 재리뷰. 작성자와 반대 벤더 |
Sonnet과 Luna를 워커로 쓰면 토큰이 덜 들고 빨라요. 대신 리뷰는 두 CLI 모두에서 max 바로 아래 단계인 xhigh로 맞췄어요. 두 리뷰어가 같은 눈높이에서 보게 하려고요. 최상위 모델이나 max는 인증, 결제, 데이터 마이그레이션 같은 고위험 단계라도 스스로 올리지 않고 먼저 묻습니다. 이건 비용과 통제의 결정이지 측정의 결과는 아니에요.
표에서 모델을 최신 Sonnet처럼 적은 데도 이유가 있어요. 모델 설정은 제품군 이름이고 실제로 도는 건 디스패치 직전에 확인한 그 제품군의 최신 버전입니다. 처음엔 모델 ID를 고정해 두었는데, 새 버전이 나온 뒤에도 옛 ID가 그대로 돌고 있었거든요. 최신을 확인할 수 없으면 다른 모델로 대체하지 않고 그 레인을 멈춰요.
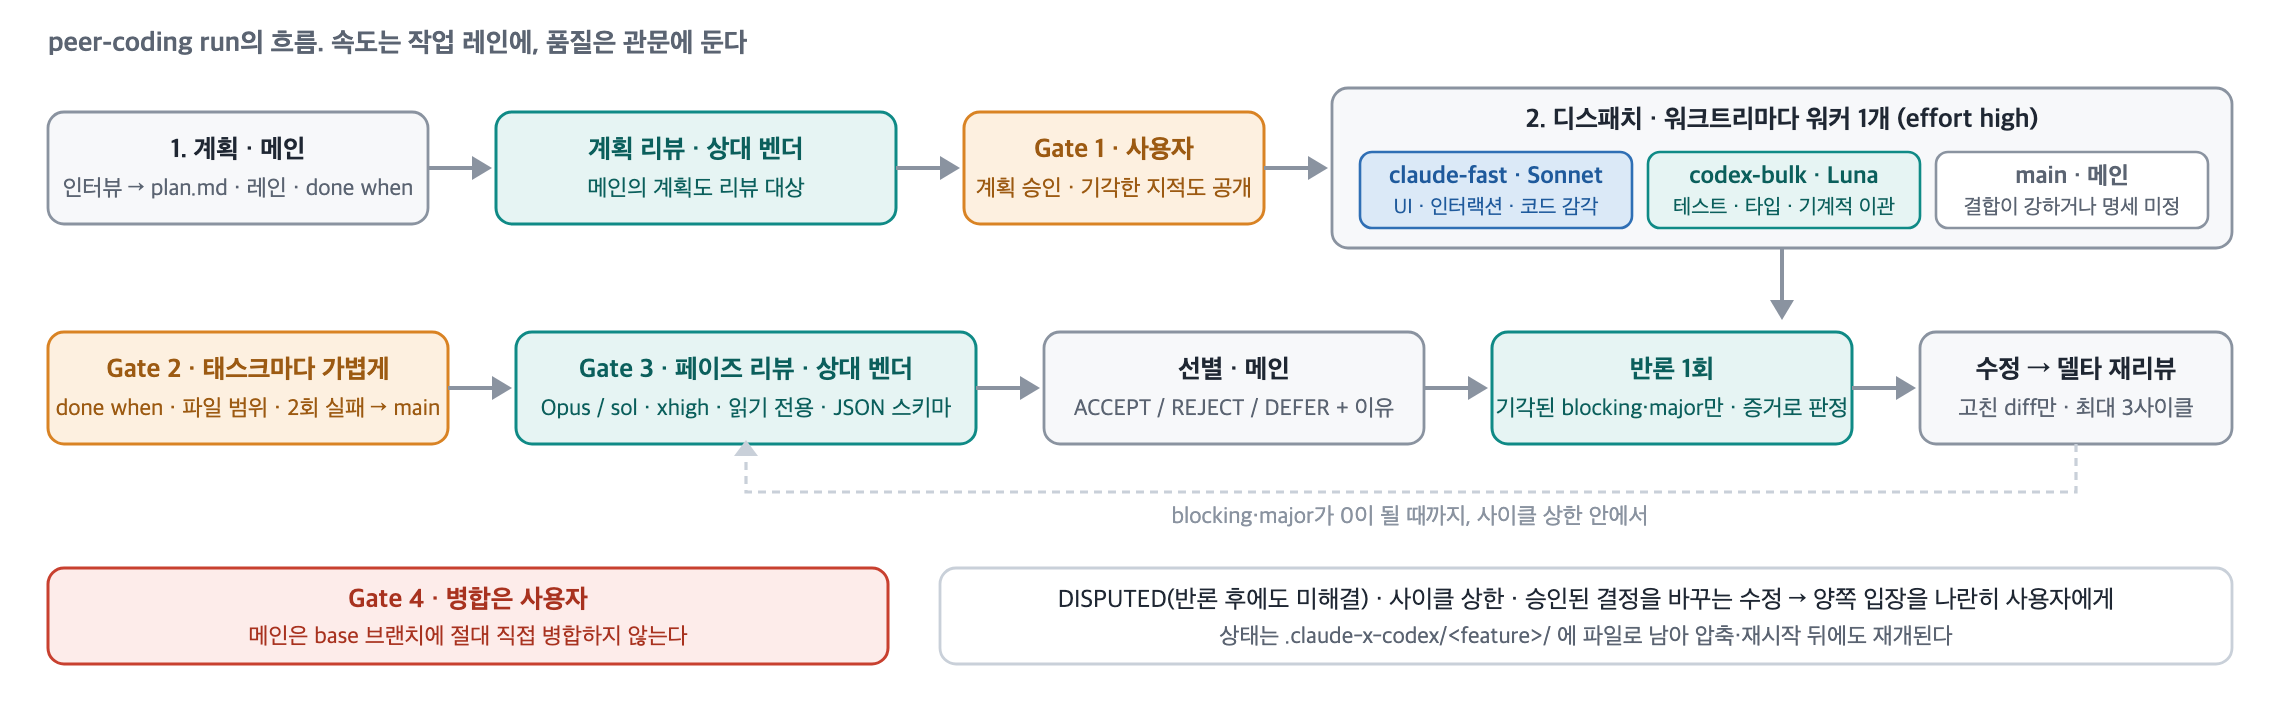
그리고 모든 루프에는 상한이 있어요. 한 페이즈의 태스크가 모두 끝나면 받는 페이즈 리뷰는 blocking과 major가 0이 되면 끝나고, 리뷰·수정·재리뷰 사이클은 기본 3회에서 멈춥니다. 리뷰어가 만족할 때까지가 아니라요. 다음 단계로 넘길지 정하는 자리를 관문이라 부르는데, 마지막 관문인 병합은 메인이 절대 직접 하지 않고 사용자에게 넘겨요.
Orca( Orchestration ide )가 없어도 돌아가게
Orca는 데스크톱에서 여러 CLI 세션을 띄우고 run, task, worker를 관리하는 런타임이에요. 있으면 워커가 작업 중에 질문할 수 있고 관문이 사용자의 결정을 기다려요. 저는 Orca 위에서 쓰지만 없는 분들도 쓸 수 있게 만들고 싶었어요.
그래서 전송 계층을 둘로 나눴습니다. Orca가 있으면 양방향, 없으면 단방향이에요. 단방향에서는 워커가 질문을 못 하니 위임 프롬프트가 질문을 미리 예상해야 하고, 남는 건 워커가 돌려주는 반환문의 Uncertain 섹션에 적혀 메인이 태스크 관문에서 풀어요. 리뷰는 두 경우 모두 읽기 전용 CLI 호출로 돌아요.
# 단방향 전송의 Codex 워커 호출 (요약). CXC_ 와 .claude-x-codex 는 옛 이름 claude-x-codex 의 흔적
CXC_MODE=off codex exec -m "$MODEL" -c model_reasoning_effort=high \
  -C .claude-x-codex/wt/T2 -s workspace-write \
  -c 'project_doc_fallback_filenames=["CLAUDE.md"]' \
  -o "$F/returns/T2.md" "$(cat "$F/tasks/T2.md")" < /dev/null
실제로 plan-smith를 은퇴시키는 작업은 이 단방향 경로로 했어요. 그 작업을 하던 환경에서는 Orca 워커가 뜨지 않았거든요. README 다섯 언어를 고치는 일은 codex-bulk 레인이 맡았고 Claude 리뷰어가 9건을 지적해 전부 받아들인 뒤 수정분만 델타 재리뷰로 넘겼습니다.
두 벤더가 같은 바닥에서 시작하게
동료 리뷰가 성립하려면 두 에이전트가 같은 프로젝트 맥락에서 출발해야 해요. 그런데 둘은 읽는 파일부터 다르거든요. Claude Code는 CLAUDE.md를 읽고 없으면 AGENTS.md로 넘어가요. Codex는 AGENTS.md를 읽고 CLAUDE.md는 project_doc_fallback_filenames 설정을 줄 때만 읽습니다. 둘 다 있으면 각자 자기 파일만 읽고요. 이건 제 측정용 레포 z-lab에서 세 번씩 돌려 확인한 동작이에요.
그래서 peer-coding의 스킬 중 audit은 그 간극을 읽기 전용으로 보고하고 run은 레포를 바꾸지 않는 방법부터 써요. 독립 실행 Codex 호출에는 폴백 플래그를 붙이고 레포에 한쪽 지침 파일이 다른 쪽을 가리키게 하는 포인터 파일을 두는 변경은 계획 승인 때 제안만 해요. 두 벤더 중 한쪽을 기준으로 삼지 않는 것이 원칙입니다.
맥락을 맞춘 다음 손본 것은 리뷰어의 권한이었어요.
"리뷰어를 읽기 전용으로 묶으려면 도구를 어디까지 줄여야 할까?"
라고 고민하다가 이것도 재서 정했어요. 처음엔 --tools 허용 목록으로 도구를 줄였는데, 평범한 리뷰에서도 컨텍스트가 6배, 비용은 Opus에서 최대 9배까지 뛰었습니다. 허용 목록이 컨텍스트에 정체를 알 수 없는 큰 내용을 끼워 넣고 있었던 거예요. --disallowedTools 거부 목록으로 바꾸니 컨텍스트 증가 없이 Skill, ReportFindings, Write, Edit만 빠졌어요.
측정한 것과 체감한 것
근거의 층위를 나눠 적어 둘게요.
- 측정한 것은 스킬이 기대는 CLI 동작입니다. 20개 프로브를 65회 돌려 어느 벤더가 어떤 지침 파일을 읽는지, 리뷰 스키마가 강제되는지, 리뷰어가 쓰기를 못 하는지, 전송 명령이 끝까지 도는지를 확인했어요. 문서와 달랐던 다섯 가지가 플러그인을 고치는 근거가 됐고 모드가 켜져 있음을 프롬프트마다 알리는 mode 훅이 입력 토큰을 약 100개 늘린다는 것도 여기서 나왔고요.
- 측정하지 않은 것은 리뷰 품질과 모델 간 비교예요. z-lab에서는 다른 벤더의 리뷰가 더 좋은지를 재지 않았습니다.
- 체감한 것은 글머리의 "지적사항 없음"이에요. P1, P2는 지금도 붙지만, 같은 리뷰 에이전트가 같은 레포에서 그 결과를 처음으로 내기 시작한 것은 사실이고요. 다만 통제된 실험이 아니라 한 레포에서의 관찰이기 때문에 전부 peer-coding 덕이라고 말할 수는 없습니다.
이름 이야기도 하나 적어 둘게요. 원래 이름은 claude-x-codex였는데, Claude Code 2.1.287이 claude-로 시작하는 플러그인 이름을 예약어로 막으면서 마켓플레이스 검증이 깨졌어요. 그래서 peer-coding으로 바꿨고 사용자 환경에 이미 쓰인 상태 폴더와 CXC_ 변수 이름은 그대로 두었고요.
🔗z-lab · claude-x-codex-lab 측정 기록
마치며...
오케스트레이션을 하면서 생각하게 된 건, 에이전트도 결국 확률로 답을 내기 때문에 모델의 특성을 무시할 수 없다는 점이에요. 내가 둘이면 두 배 빨라지고 어느 정도 나아지기도 하지만, 못하는 건 그대로고 다시 보면 또 다른 것만 보여 끝이 나지 않죠. 나와 역량이 다른 사람과 함께하면 서로 교차하는 자리를 볼 수 있어 더 나은 것을 만들 수 있고요. 서로 다른 사고를 가진 에이전트가 서로 못하는 것을 리뷰할 때 가치가 커지는 이유가 여기 있다고 봅니다.
우리 사회와 닮았다고 느꼈어요. 지난 회고에서 함께가 더 강하다고 썼는데, 그 문장이 모델과 모델 사이에서도 성립하는 걸 보고 있죠.
🔗[ 2026. 09. 05 ] 일반 회원에서 모임장까지, 함께의 힘은 여전히 유효하다
다음 글은 자리를 비우는 동안 작업을 끝까지 밀고 가는 free-hands 이야기로 포스팅 해볼게요. AI에게 어디까지 결정을 맡길지, 그 경계를 어디에 두었는지를 적을 생각이에요. 저는 사회에 기여하는 개발자가 되고 싶고, 함께하면 더 강하다는 것을 이번에도 재확인 할 수 있었어요.
'AI' 카테고리의 다른 글
| [ AI Agent skill ] 자리를 비우는 동안, AI는 어디까지 결정해도 될까 (1) | 2026.10.04 |
|---|---|
| [ Claude Code Plugin ] 필요해서 만든 플러그인을 통합했습니다, 한 개는 제외하고요 (2) | 2026.10.03 |
| [ Claude Code ] Enter를 치면 일어나는 일 (0) | 2026.08.27 |
| [ Claude Code Plan ] "Fable은 대체 뭐가 다를까?" 76개 플랜을 뜯어본 실험기 (1) | 2026.08.16 |
| [ Harness ] Anthropic은 80%, 나는 75%의 시스템 프롬프트를 지웠다 (0) | 2026.08.04 |